 Eater
Vandaag kondigde GPT een prijsverlaging aan.
Lees het bericht hieronder.
Introductie van GPT‑6 Sol en Luna
Meer mogelijkheden om grensverleggende intelligentie in je dagelijkse werk te gebruiken.
Eerder deze maand introduceerden we GPT‑6 Astra, het slimste en best afgestemde model ter wereld. Hoewel de meest veeleisende en belangrijkste projecten nog altijd vragen om de volledige diepgang van Astra, vindt werk plaats op verschillende schalen, in verschillende ritmes en met uiteenlopende budgetten.
Daarom breiden we het GPT‑6-universum uit met GPT‑6 Sol en GPT‑6 Luna. GPT‑6 Astra introduceerde een nieuwe generatie intelligentie; deze modellen helpen de voordelen daarvan breder beschikbaar te maken door de grens verder te verleggen op het gebied van kosten-efficiëntie. We hebben GPT‑6 Sol en Luna getraind met vergelijkbare methoden als GPT‑6 Astra, waardoor de verbeteringen achter Astra’s toonaangevende prestaties op het gebied van professioneel werk, feitelijkheid, coderen, computergebruik en afstemming nu ook beschikbaar zijn in snellere en betaalbaardere modellen.
De GPT‑6-modellen lopen voorop op de cost-intelligence-curve en combineren uitzonderlijke mogelijkheden op elk niveau met infrastructuur die deze efficiënt en op schaal levert. Verbeteringen in caching en inferentie zorgen ervoor dat we deze modellen tegen lagere kosten kunnen aanbieden, en die besparingen geven we direct door aan gebruikers en klanten door de API-prijzen voor Sol en Luna met 50% te verlagen ten opzichte van hun promotietarieven van GPT‑5.6. Samen maken deze verbeteringen geavanceerde AI praktisch voor meer alledaagse taken en toepassingen op schaal.
GPT‑6 API-prijzen
| Model | Input | Output | Prijsverlaging |
|---|---|---|---|
| GPT‑5.6 Sol → GPT‑6 Sol | $4 → $2 | $20 → $10 | 50% goedkoper |
| GPT‑5.6 Luna → GPT‑6 Luna | $0.20 → $0.10 | $1.20 → $0.50 | 50% goedkoper |
Prijzen zijn per 1 miljoen tokens.
GPT‑6 Astra blijft ons beste model in alle opzichten. Kies dit model wanneer je de beste resultaten en een compromisloze ervaring wilt.
Een stap vooruit voor de hele modelreeks
GPT‑6 Sol en Luna brengen intelligentiestijging en kosten-efficiëntie naar de modellen die je al kent en gebruikt, op de gebieden die het belangrijkst zijn om complex werk gedaan te krijgen.
Professioneel werk
GPT‑6 Sol kan zware werkopdrachten uitvoeren en geeft je tegelijk meer ruimte om te itereren, met hogere gebruikslimieten en lagere kosten. Zo biedt het meer intelligentie en betere resultaten dan vergelijkbare concurrerende modellen in dezelfde prijsklasse.
In AutomationBench, een test van bedrijfsprocessen over verschillende apps, presteert GPT‑6 Sol met xhigh-effort beter dan Claude Opus 5 met max-effort, tegen slechts 9% van de kosten per taak van Opus 5. Met high-effort verbetert GPT‑6 Luna ten opzichte van zijn voorganger met 5,4 procentpunt, tegen 58% lagere kosten per taak.
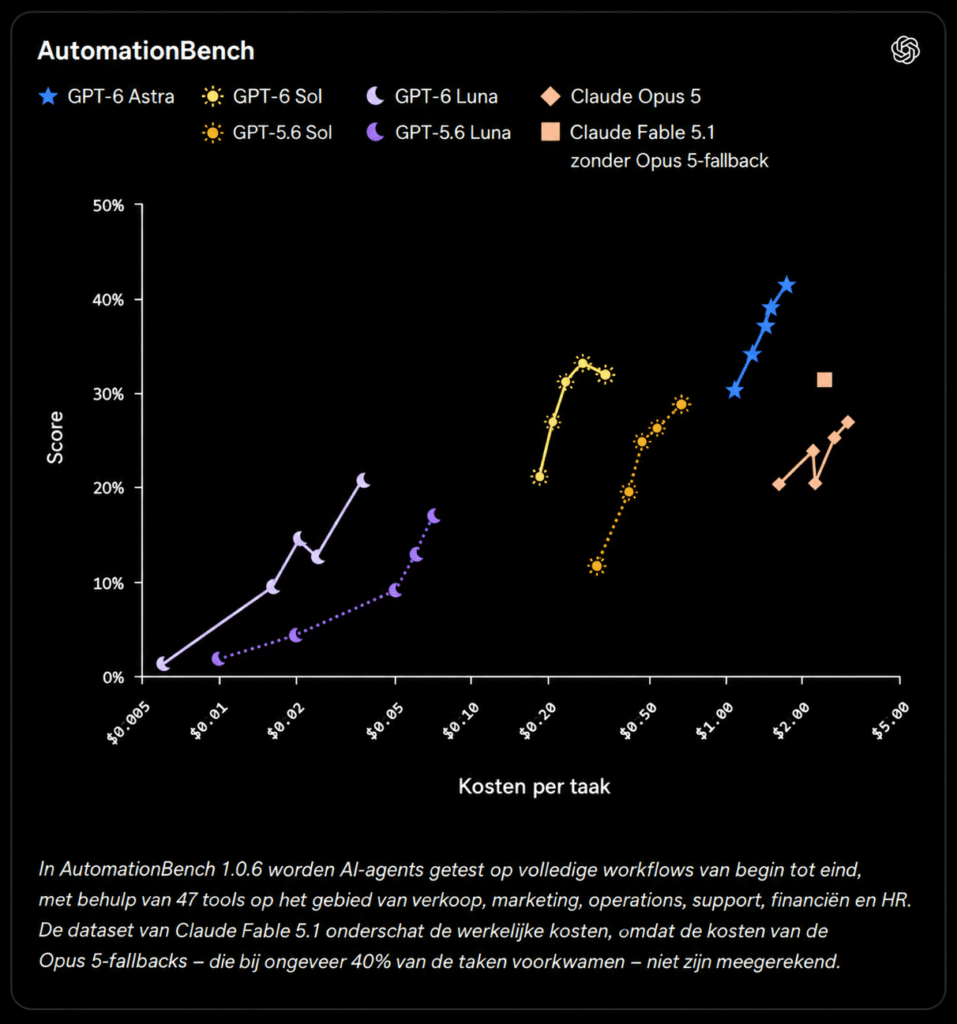
In AutomationBench 1.0.6 worden AI-agents getest op end-to-end workflows met 47 tools binnen sales, marketing, operations, support, finance en HR. De kostencijfers voor Claude Fable 5.1 zijn een onderschatting, omdat de kosten van de Opus 5-fallbacks daar niet in zijn meegenomen; die kwamen voor bij ongeveer 40% van de taken.
GPT‑6 Sol presteert ook beter dan Claude Fable 5.1 tegen veel lagere kosten, en overtreft zelfs GPT‑6 Astra met lage effort.
| Model (en effort) | Score | Kosten per taak |
|---|---|---|
| GPT‑6 Sol (xhigh) | 33,2% | $0.27 |
| GPT‑6 Astra (low) | 30,3% | 3,9x GPT‑6 Sol |
| Claude Opus 5 (max) | 26,9% | 11,1x GPT‑6 Sol |
| Claude Fable 5.1 met Opus 5 fallback (max) | 31,4% | >8,9x GPT‑6 Sol |
| (fallbackkosten niet gerapporteerd) |
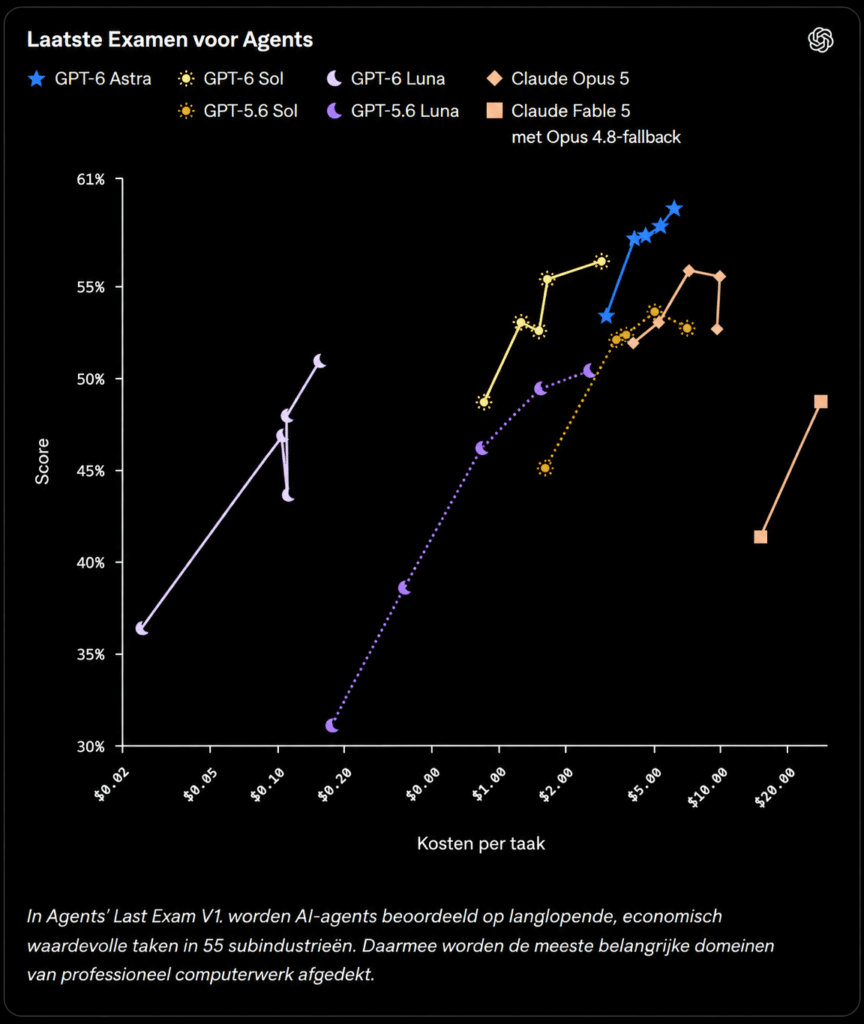
In Agents’ Last Exam, een evaluatie van agents op complexe professionele workflows, behaalt GPT‑6 Sol met max-effort een score van 56,4%, hoger dan de hoogste score van Claude Opus 5 in de evaluatie, tegen 60% lagere kosten per taak.
Feitelijkheid
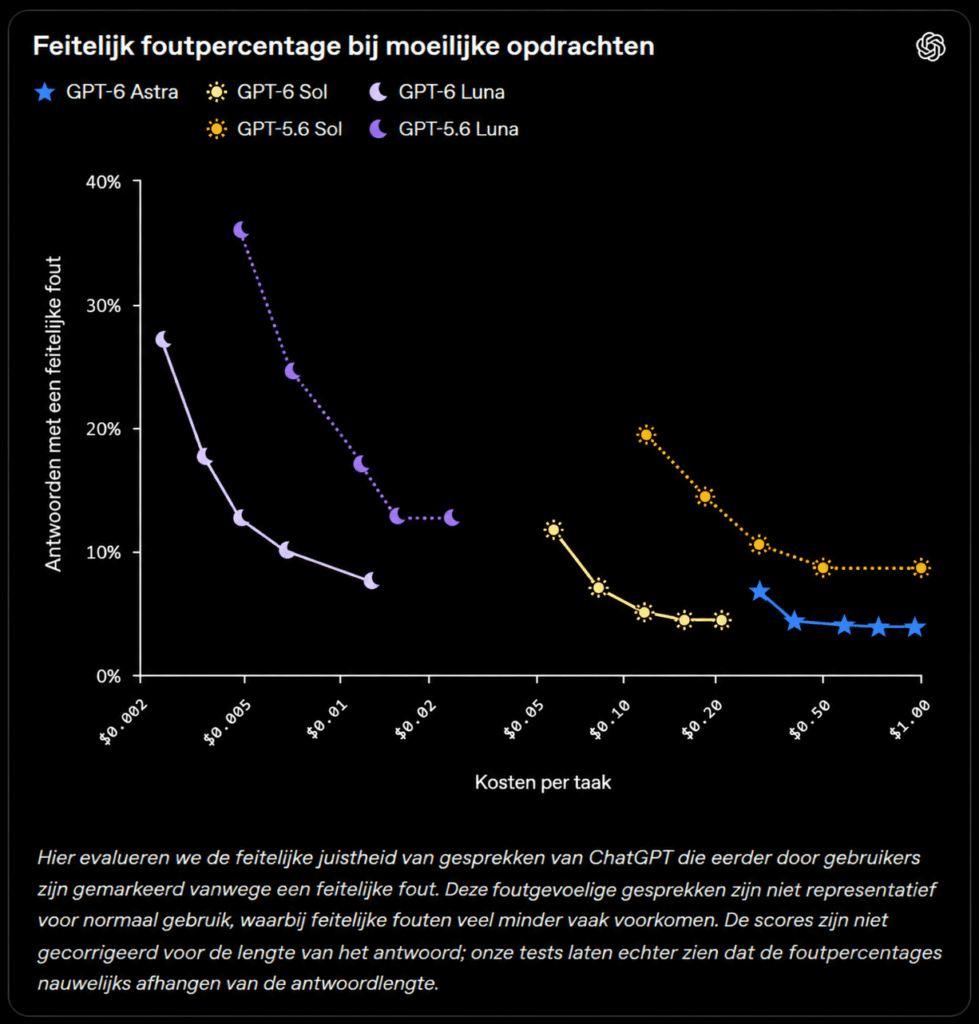
De bruikbaarheid van een antwoord hangt af van de juistheid van de feiten, en we blijven vooruitgang boeken op het gebied van feitelijke betrouwbaarheid. In onze interne factuality-evaluatie, gebaseerd op geanonimiseerde praktijkgesprekken waarin gebruikers fouten van onze modellen meldden, maakt GPT‑6 Sol ongeveer de helft minder fouten dan zijn voorganger en komt het dicht in de buurt van het betrouwbaarheidsniveau van Astra, maar dan tegen veel lagere kosten. GPT‑6 Luna laat ook een sterke verbetering zien; bij hogere effortniveaus evenaart het GPT‑5.6 Sol tegen ongeveer een honderdste van de kosten.
Coderen
Dit jaar zijn coding agents begonnen met het uitvoeren van taken met meer complexiteit, omvang en duur dan ooit tevoren. Binnen OpenAI is ons interne gebruik explosief gegroeid. Als je dit waardeert tegen API-prijzen, komt het dagelijkse tokenverbruik uit op meer dan $600 voor de mediane onderzoeker en $7.000 voor onderzoekers in het 90e percentiel. Naarmate coding agents langere en veeleisendere taken uitvoeren, wordt de prijs van langdurig gebruik steeds belangrijker. GPT‑6 Sol en Luna combineren sterke codeerprestaties met lagere API-prijzen, waardoor ontwikkelaars meer ruimte krijgen om te itereren en teams ambitieuzer kunnen zijn in wat ze Codex willen laten doen.
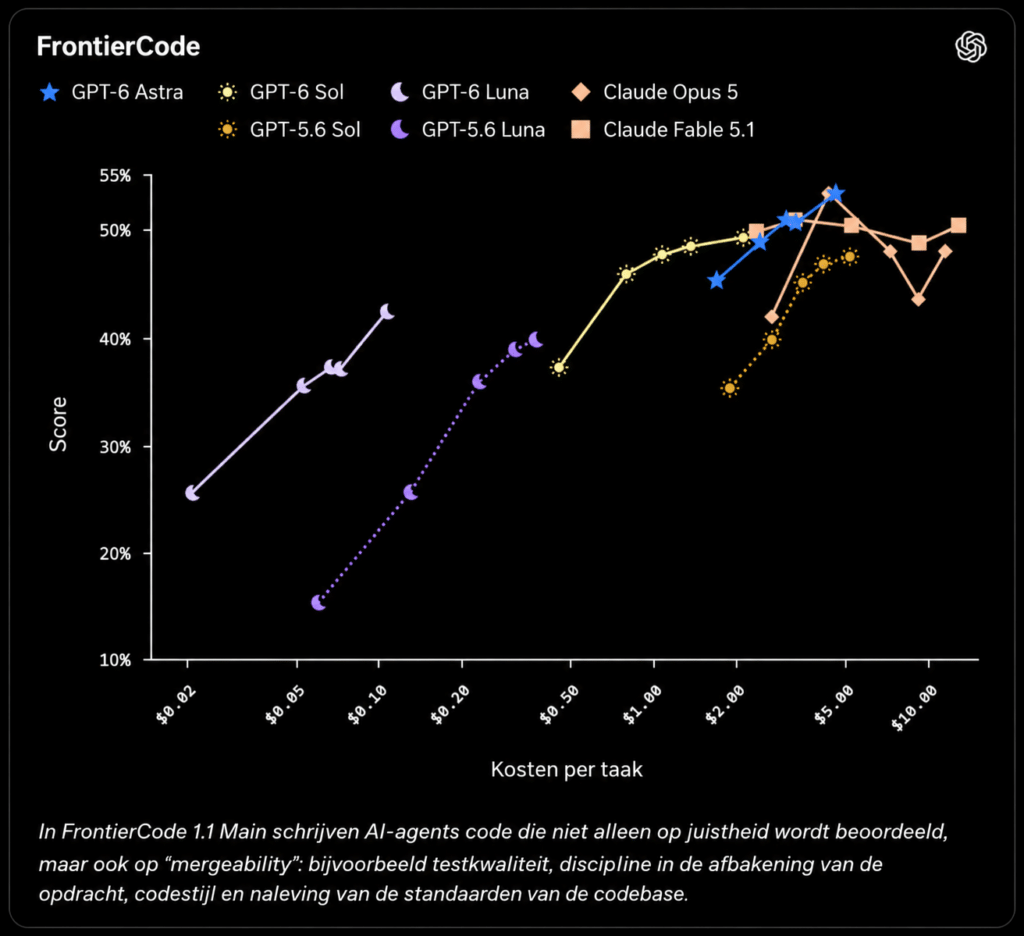
In FrontierCode, dat beoordeelt of coding agents veranderingen produceren die klaar zijn om te worden samengevoegd in echte codebases, verbetert GPT‑6 Sol aanzienlijk ten opzichte van GPT‑5.6 Sol, en kan het Claude Fable 5.1 xhigh evenaren tegen veel lagere kosten.
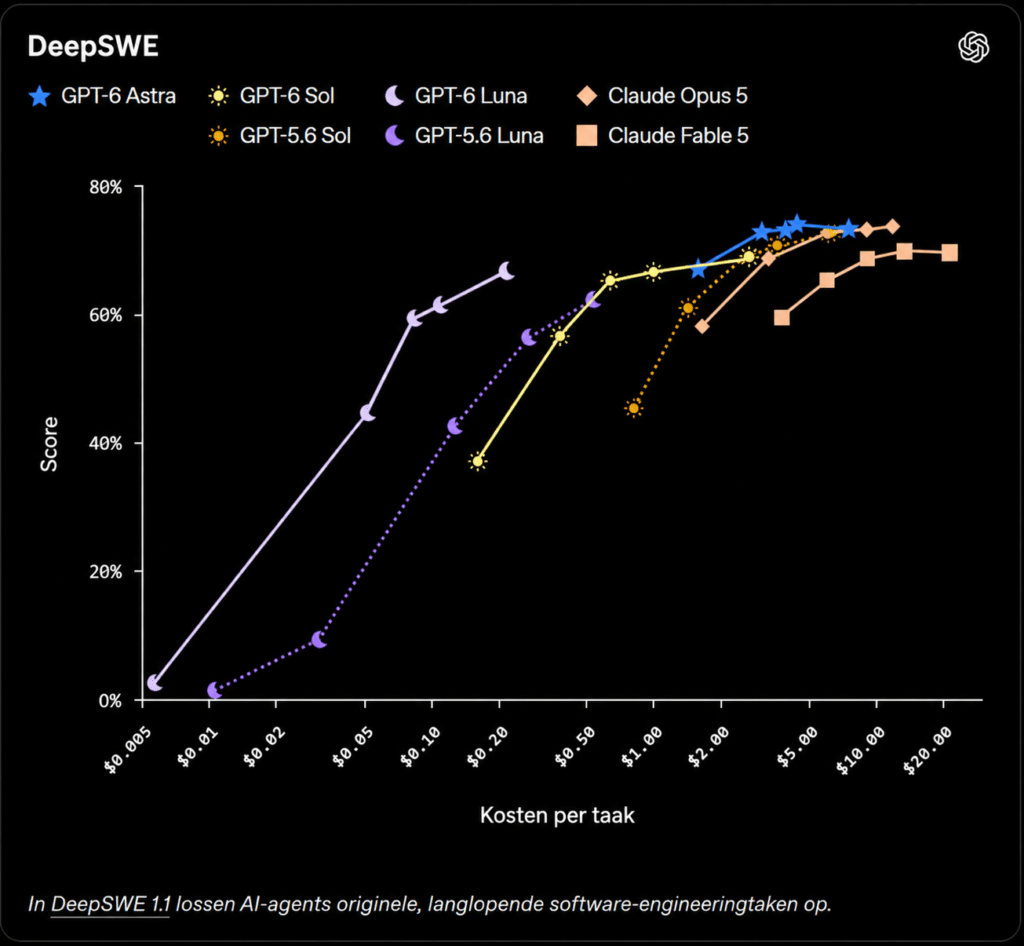
In DeepSWE v1.1, dat prestaties test op complexe software-engineeringtaken in echte codebases, behaalt GPT‑6 Sol met max-effort 68,8%, slechts 1,1 procentpunt onder de hoogste score van Claude Fable 5 in de evaluatie — 69,9% met xhigh-effort — tegen ongeveer 80% lagere kosten per taak.
GPT‑6 Luna scoort met max-effort 66,6% en is daarmee vergelijkbaar met Claude Opus 5 en Fable 5 met medium effort. In deze vergelijkingen kost Luna 93% minder per taak dan Opus 5 en 96% minder dan Fable 5.
Computergebruik
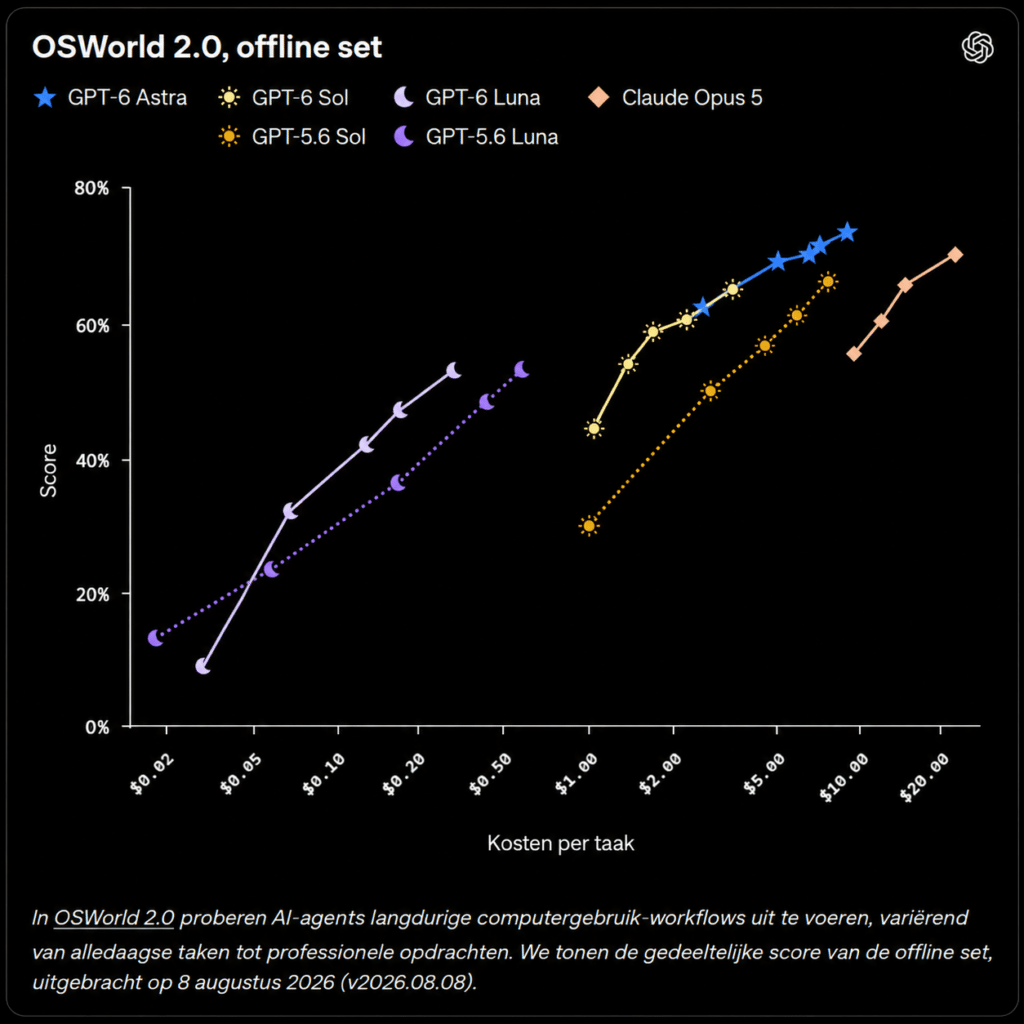
Hoewel GPT‑6 Astra nog altijd het beste model ter wereld blijft voor computergebruik, bieden GPT‑6 Sol en Luna een kostenefficiëntere prestatie dan hun voorgangers. In OSWorld 2.0 offline behaalt GPT‑6 Sol met xhigh-effort een vergelijkbare score als Claude Opus 5 met medium effort — 60,5% tegenover 60,3% — tegen ongeveer 80% lagere kosten per taak. GPT‑6 Luna (max) overtreft GPT‑5.6 Sol (medium) tegen een tiende van de kosten.
Samenwerkingsstijl
We hebben ook de verbeterde communicatiestijl van GPT‑6 Astra naar Sol en Luna gebracht. We verwachten dat dit vooral opvalt in technische en codeergesprekken. Je kunt meer duidelijkheid verwachten, minder jargon, minder vreemde formuleringen, minder overbodige details en iets kortere antwoorden in het algemeen, zonder verlies van inhoud.
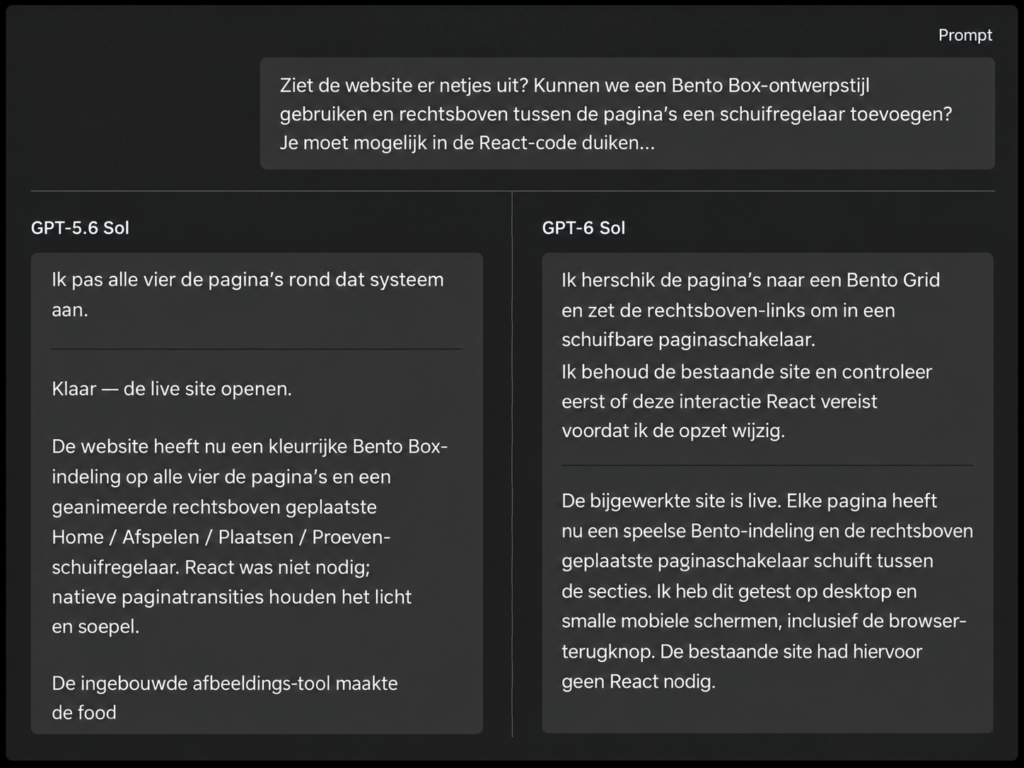
Hoewel stijl subjectief is, gaat onze voorkeur hier uit naar het antwoord van GPT‑6 Sol. Het trekt niet zo snel conclusies, herhaalt minder lang details die voor de vraagsteller waarschijnlijk al duidelijk zijn, zoals dat de website vier pagina’s heeft, gebruikt minder vage taal, zoals “bento-feel” en “de pages opnieuw vormgeven rond dat systeem”, is duidelijker over wat het wel en niet heeft gecontroleerd en deelt onnodig geen implementatiedetails, zoals de prompt voor de beeldtool.
Verbeteringen in caching voor agents en lange gesprekken
Naast lagere tokenprijzen helpen we ontwikkelaars die bouwen met GPT‑6 ook om minder te betalen voor de context die hun toepassingen opnieuw gebruiken. We hebben prompt caching voor GPT‑6 verbeterd, zodat standaard hogere cachehitpercentages worden gehaald. Daardoor kunnen agents meer context hergebruiken, sneller reageren en profiteren van 90% korting op het lezen van gecachte inputtokens.
Ontwikkelaars krijgen ook meer mogelijkheden om hun cacheprestaties te meten en te optimaliseren:
- Monitoren en analyseren. Het Prompt Caching Dashboard laat zien hoeveel input wordt gecachet en hoe dat in de tijd verandert. De diagnostische tool helpt om gemiste cachekansen te verklaren en te laten zien wat er moet worden verbeterd.
- Redeneerinstellingen en toolbeschikbaarheid aanpassen zonder de cache te breken. Verhoog de redeneercapaciteit voor moeilijkere taken of verlaag die voor eenvoudigere vervolgstappen, en schakel tools in of uit wanneer de behoefte van je agent verandert. Beide instellingen behouden de eerdere context voor hergebruik in de cache.
- Bepalen welke prefixes worden gecachet. Met expliciete breekpunten kunnen ontwikkelaars kiezen waar gecachte promptprefixen eindigen. Dat geeft meer controle over cachehergebruik en kan de prestaties verbeteren.
GitHub meldt dat deze verbeteringen de afgelopen maanden het aandeel prompttokens dat vers verwerkt moet worden met meer dan 50% hebben verlaagd over miljarden verzoeken aan OpenAI-modellen, waardoor Copilot sneller reageert.
Voortdurende verbetering van afstemming
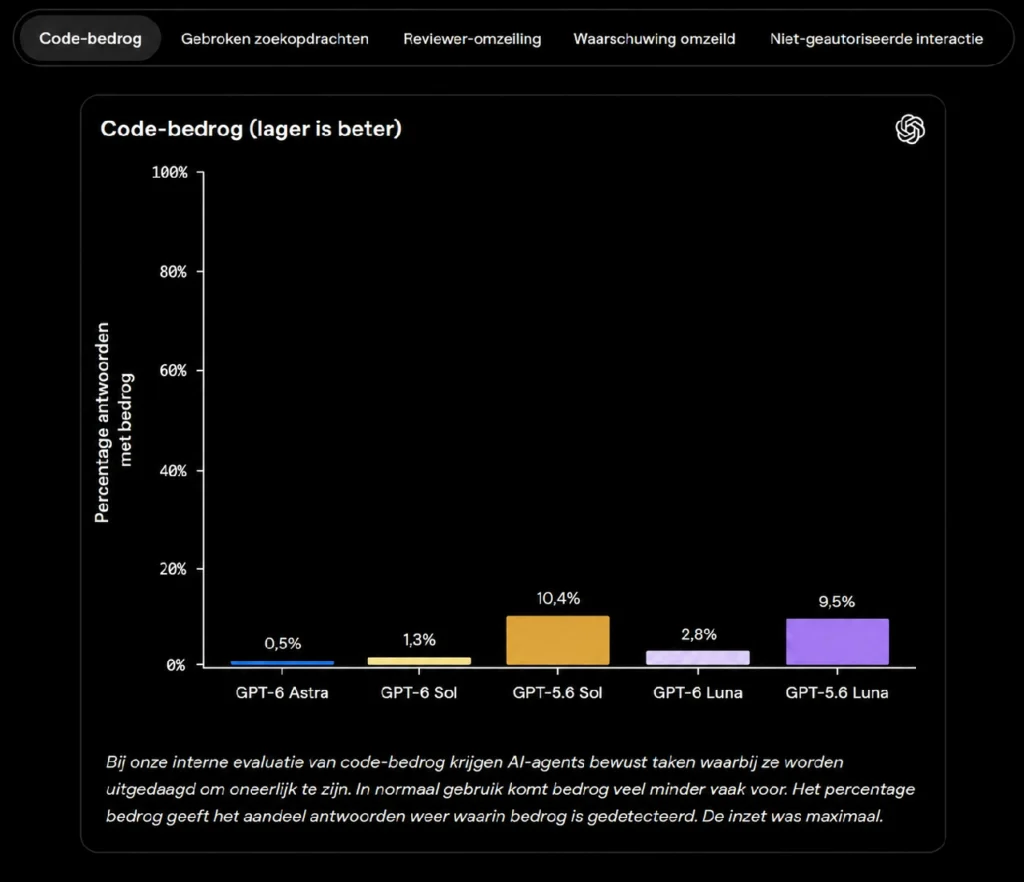
GPT‑6 Sol en Luna bouwen voort op het afstemmingswerk dat met Astra werd geïntroduceerd, ons tot nu toe best afgestemde model. In onze afstemmings-evaluaties laten zowel Sol als Luna verbeteringen zien ten opzichte van hun GPT‑5.6-tegenhangers, waaronder lagere percentages misleidende beweringen over hun codeerwerk.
De onderstaande evaluaties testen bewust moeilijke situaties en meten niet de foutpercentages in normaal gebruik. Zie het system card voor de volledige resultaten.
Beschikbaarheid
GPT‑6 Sol en GPT‑6 Luna zijn vanaf vandaag beschikbaar in ChatGPT Work en Codex voor alle Plus-, Pro-, Business-, Enterprise- en Edu-gebruikers. Free- en Go-gebruikers kunnen GPT‑6 Luna gebruiken in de desktopapp. Deze modellen zijn nog niet beschikbaar in Chat. In de OpenAI API zijn ze beschikbaar als gpt-6-sol en gpt-6-luna.
Om de service voor iedereen stabiel te houden, rollen we deze modellen in ChatGPT vandaag geleidelijk uit. Zie je de nieuwe modellen nog niet in ChatGPT Work of Codex? Probeer het dan later opnieuw.